كيف حققنا ترجمة مباشرة في أقل من 700 مللي ثانية
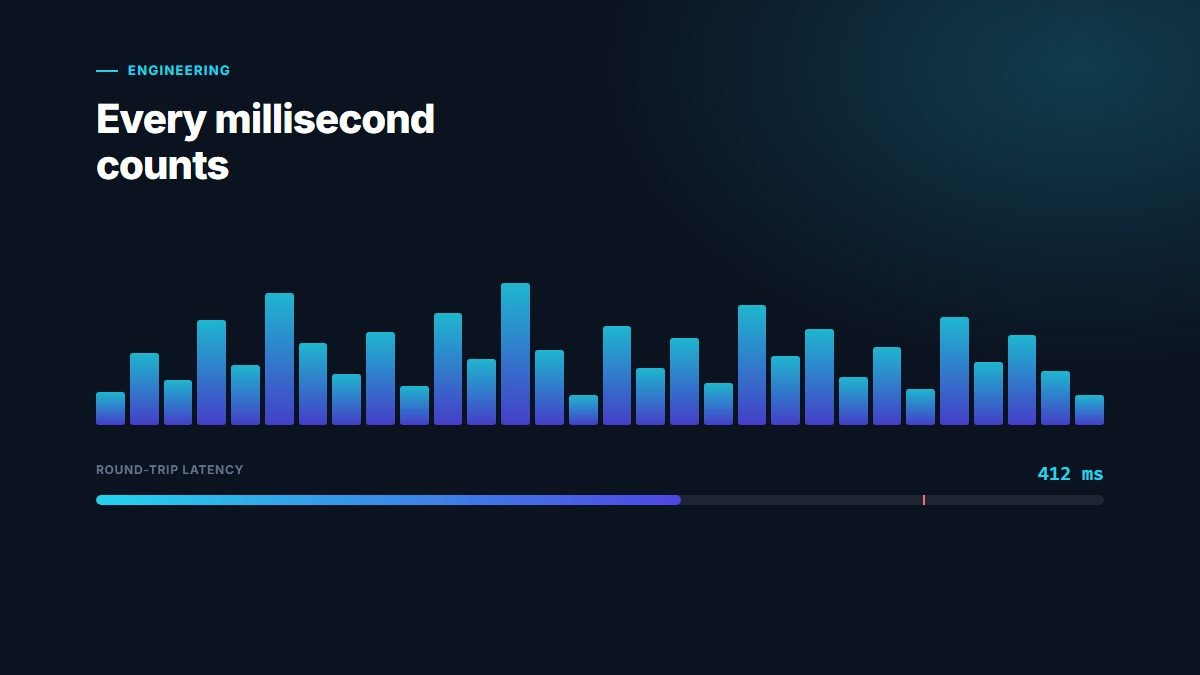
الميزانية الزمنية هي الجزء الصعب، لا النموذج
يفترض الجميع أن زمن استجابة ترجمة الكلام مشكلة نموذج: اختر محرك تعرف أسرع، ونموذج ترجمة أسرع، وصوتا أسرع، وسينخفض الرقم. في FluenSync، منتجنا لترجمة الكلام إلى كلام في الوقت الفعلي عبر الويب وiOS وAndroid، كان لتبديل النماذج أثر أقل مما توقعنا. ما أوصلنا فعلا إلى أقل من 700 مللي ثانية عبر 14 لغة فأكثر هو بنية خط المعالجة المحيطة بالنماذج.
تقطيع الكلام قبل اكتماله
يعتمد النهج المبسط على انتظار توقف، ثم إرسال العبارة كاملة إلى التعرف، ثم إلى الترجمة، ثم إلى التوليف الصوتي. تنتظر كل مرحلة انتهاء سابقتها، وتستهلك فترات التوقف وحدها جزءا من الميزانية قبل معالجة كلمة واحدة. نقوم بدلا من ذلك ببث مقاطع صوتية ثابتة الحجم إلى مرحلة التعرف فور وصولها، ونتركها تصدر نصوصا جزئية باستمرار. تبدأ الترجمة على المقاطع المستقرة التي لن يعدلها محرك التعرف، دون انتظار نص نهائي. هنا يُسترد معظم الميزانية، لا من تسريع نموذج واحد.
أين يقيم الاتصال
تقع المراحل الثلاث خلف اتصال WebSocket واحد لكل جلسة بدلا من ثلاث عمليات منفصلة. يتجنب WebSocket تكلفة إنشاء اتصال جديد مع كل مقطع، ويتيح لنا دفع النتائج الجزئية إلى العميل فور توفرها بدلا من انتظاره لاستطلاعها. وعلى الجوال، يحمل الاتصال نفسه الصوت صعودا والكلام المولّد نزولا، فتصبح هناك رحلة ذهاب وإياب واحدة تُحتسب، لا عدة رحلات.
الميزانية التي نتتبعها فعليا
- الالتقاط والتقطيع على الجهاز: شريحة صغيرة ثابتة، لا العبارة كاملة.
- الشبكة صعودا: إطار WebSocket واحد، لا اتصال جديد مع كل مقطع.
- التعرف على مقطع مستقر: إرجاع النتيجة فور التأكد من أنه لن يُعدَّل.
- الترجمة على ذلك المقطع: مُدخل صغير بما يكفي ليبقى زمن استجابة النموذج قابلا للتنبؤ.
- التوليف: بدء توليد الصوت لمقطع قبل اكتمال ترجمة المقطع التالي.
- الشبكة نزولا والتشغيل: بث متواصل، لا تسليم كملف واحد في النهاية.
لكل مرحلة هدف زمني بالمللي ثانية خاص بها، ونقيسها كل على حدة بدلا من الاكتفاء بالرقم الإجمالي، لأن مرحلة واحدة بطيئة تختفي داخل المعدل العام لكنها تبقى واضحة جدا للشخص الذي ينتظر.
التعامل مع الشبكة، لا خط المعالجة وحده
خط المعالجة السريع على اتصال مستقر يفشل مع ذلك في الميدان إذا افترض أن الشبكة لا تتعثر أبدا. تُسقط اتصالات الجوال الإطارات، وتُعيد ترتيب الحزم، وتتوقف في منتصف الجملة. نُشغّل مخزنا مؤقتا صغيرا للتذبذب على جهاز العميل لامتصاص الفجوات القصيرة دون توقف التشغيل، ونُرمّز الصوت بترميز مُصمم لعرض النطاق المنخفض بدلا من ترميز مُعاير لحجم الملف. وعندما ينقطع اتصال WebSocket في منتصف الجلسة، يعيد جهاز العميل الاتصال ويستأنف الجلسة بدلا من بدء جلسة جديدة، فتكلف الانقطاعات اللحظية تعثرا بسيطا لا إعادة بدء من الصمت. لا يظهر شيء من هذا في رقم زمن استجابة يُقاس على شبكة مختبر، لكنه ما يقرر ما إذا كانت ميزانية 700 مللي ثانية تصمد على هاتف داخل قطار متحرك.
ما اخترنا عدم فعله
لم نطارد أسرع نموذج بمعزل عن غيره، لأن نموذجا أسرع بقليل ينتظر عبارة كاملة يخسر أمام نموذج أبطأ قليلا يستطيع البدء على مقطع جزئي. كما لم نحاول التقدم بتخمين استمرارات احتمالية، لأن التخمين الخاطئ يكلف تصحيحا شفهيا أكثر مما قد يوفره من زمن استجابة. جاءت المكاسب من إزالة الانتظار الخامل بين المراحل، لا من تسريع مرحلة واحدة بمعزل عن غيرها.
ما كنا سنقوله لفريق يبني هذا
حلّل خط المعالجة مرحلة بمرحلة قبل تحسين أي نموذج بمفرده. ابثّ كل ما يمكن بثه. تعامل مع الاتصال نفسه كجزء من ميزانية زمن الاستجابة، لا مع النماذج القائمة خلفه فقط. في منتج كلام يعمل في الوقت الفعلي، ما يلاحظه الناس ليس سرعة مرحلة واحدة، بل مجموع كل نقطة انتظرت فيها مرحلة اكتمال أخرى تماما قبل البدء.